Chat Control. Kiedy prywatna wiadomość staje się przedmiotem kontroli, zanim ktokolwiek popełni przestępstwo
Milion prywatnych wiadomości, algorytm o 99-procentowej skuteczności i niemal dziesięć tysięcy fałszywych alarmów. Witamy w matematyce masowego skanowania komunikacji. Czym zajmuje się Stop Chat Control, jak działają proponowane mechanizmy kontroli i dlaczego bezpieczeństwo nie zaczyna się od automatycznego przeglądania cudzej korespondencji?
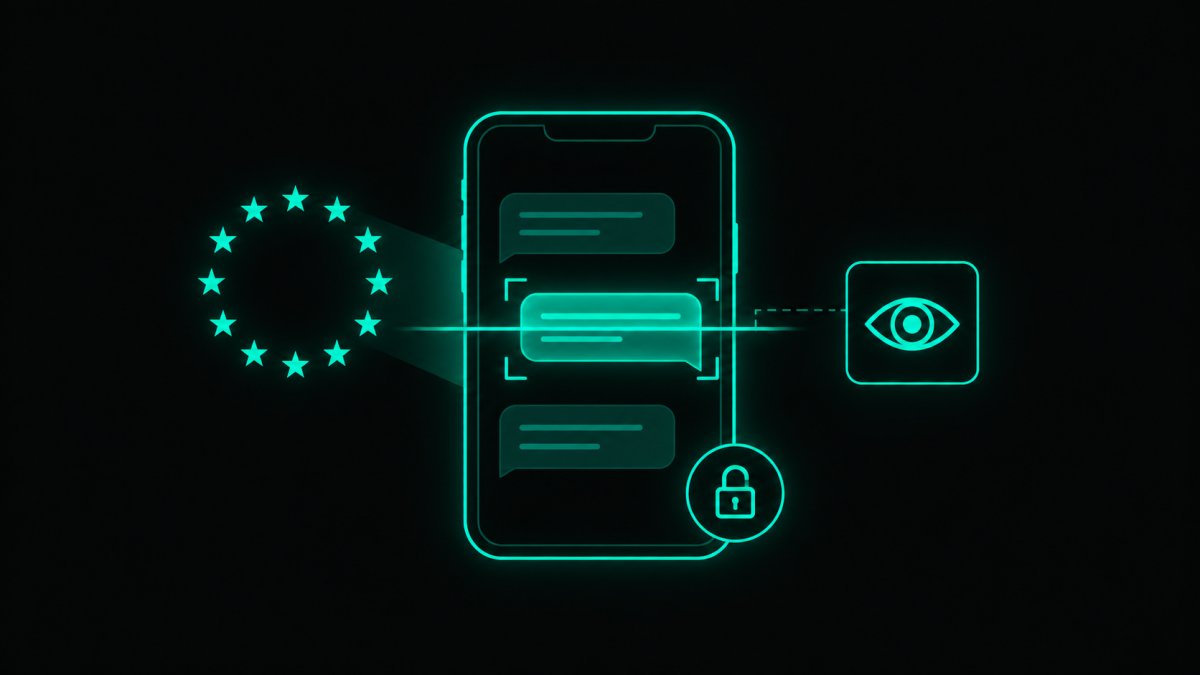
Wyobraźmy sobie następującą sytuację - chcesz wysłać znajomemu prywatną wiadomość. Zanim jednak zostanie dostarczona, specjalny mechanizm sprawdza jej zawartość, analizuje załączniki i ocenia, czy przypadkiem nie znajdują się tam materiały, których ktoś nie powinien przesyłać.
Nie jesteś podejrzanym. Nie popełniłeś żadnego przestępstwa. Żaden sąd nie wydał nakazu dotyczącego Twojej osoby. Po prostu korzystasz z komunikatora.
Brzmi jak interesujący eksperyment z zakresu nadzoru cyfrowego albo scenariusz dystopijnego filmu science fiction. Tymczasem właśnie wokół podobnych mechanizmów od lat toczy się spór dotyczący europejskich przepisów określanych mianem "Chat Control".
Oficjalny cel jest poważny: przeciwdziałanie seksualnemu wykorzystywaniu dzieci w internecie, a także walka z tak zwanym hejtem.
Problem polega na tym, że pomiędzy wykrywaniem przestępczości a systematycznym analizowaniem prywatnej korespondencji milionów niewinnych ludzi istnieje różnica, której nie da się wymazać kolejnym akapitem uzasadnienia legislacyjnego.
Stop Chat Control - dlaczego powstała ta inicjatywa?
Stop Chat Control to obywatelska inicjatywa zajmująca się monitorowaniem europejskich prac legislacyjnych dotyczących kontroli prywatnej komunikacji. Udostępnia analizy, chronologię zmian, informacje o stanowiskach instytucji oraz możliwości kontaktu z przedstawicielami parlamentarnymi.
Jej znaczenie wynika przede wszystkim z próby wyjaśnienia społeczeństwu, co faktycznie kryje się za kolejnymi wersjami projektu.
Bo mamy Chat Control 1.0, Chat Control 2.0, przepisy tymczasowe, rozwiązania dobrowolne, propozycje obowiązkowe, negocjacje trójstronne oraz kolejne kompromisy.
Człowiek chce jedynie wiedzieć, czy jego prywatna korespondencja będzie podlegała automatycznej analizie. Zamiast prostej odpowiedzi otrzymuje dokumentację procesu legislacyjnego, przy której instrukcja konfiguracji klastra Kubernetes wygląda jak lektura wakacyjna.
Inicjatywa stawia istotne pytania:
-
Czy analiza komunikacji powinna dotyczyć konkretnych podejrzanych, czy całych grup użytkowników?
-
Kto decyduje o uruchomieniu mechanizmu wykrywania?
-
Jak chronione będzie szyfrowanie end-to-end?
-
Jakie środki przysługują osobie błędnie wskazanej przez algorytm?
-
Gdzie kończy się ochrona użytkowników, a zaczyna systemowy nadzór nad ich korespondencją?
To nie są pytania o to, czy należy przeciwdziałać przestępczości. To pytania o granice i architekturę narzędzi, które mają temu służyć.
Chat Control i prewencyjna kontrola komunikacji
We wrześniu 2026 r. przedmiotem kontrowersji stała się propozycja tzw. search plans - planów umożliwiających określone działania wykrywające w obrębie usług komunikacyjnych.
Krytycy wskazują, że mechanizm obejmujący znaczną część usługi, a nie konkretnie wskazane osoby, może prowadzić do uogólnionego przeszukiwania komunikacji.
To właśnie na tym polega zarzut prewencyjnego nadzoru: wiadomości są analizowane nie dlatego, że ich nadawca został objęty indywidualnym podejrzeniem, ale dlatego, że korzysta z określonej usługi.
Zastrzeżenia wobec takiej architektury nie są wyłącznie opinią internetowych aktywistów. Europejska Rada Ochrony Danych i Europejski Inspektor Ochrony Danych ostrzegali już w 2022 r., że zbyt szeroko określone mechanizmy wykrywania mogą prowadzić do powszechnego i niezróżnicowanego skanowania komunikacji.
Warto przy tym zachować precyzję: prewencyjne skanowanie wiadomości nie jest automatycznie tym samym co cenzura prewencyjna w jej ścisłym znaczeniu konstytucyjnym. Jeżeli jednak system analizuje treść przed dostarczeniem, a następnie automatycznie ją zatrzymuje, ogranicza lub kieruje do dalszej kontroli, pojawia się realny problem uprzedniej ingerencji w poufną komunikację.
Można zmienić nazwę takiego mechanizmu. Można przygotować nowy akronim. Można nawet stworzyć niezwykle elegancką prezentację w PowerPoincie. Nie zmieni to technicznego faktu, że wiadomość zostaje poddana analizie, zanim dotrze do odbiorcy.
Matematyka ma fatalny zwyczaj ignorowania politycznych obietnic
Przejdźmy jednak do sedna. Automatyczne wykrywanie szkodliwych treści wykorzystuje między innymi dopasowywanie sygnatur, perceptual hashing, klasyfikację obrazów i modele NLP.
Każda z tych metod ma określony model działania oraz ograniczenia.
Dla systemów klasyfikacyjnych kluczowe są dwa pojęcia:
False Positive (FP) -> system wskazuje naruszenie, chociaż w rzeczywistości do niego nie doszło.
False Negative (FN) -> system nie wykrywa rzeczywistego naruszenia.
W przypadku identyfikacji znanych materiałów można wykorzystywać ich cyfrowe odciski. Znacznie trudniejsze staje się rozpoznawanie nieznanych obrazów, kontekstu rozmowy, intencji nadawcy czy potencjalnie przestępczego charakteru określonej wypowiedzi.
Spójrzmy na prosty, hipotetyczny przykład.
Załóżmy, że system analizuje milion wiadomości. Rzeczywiste naruszenie występuje w 0,1% z nich. Klasyfikator osiąga 99% czułości i 99% swoistości.
Brzmi imponująco, prawda?
Oto rezultat:
| Wynik analizy | Liczba |
|---|---|
| Wiadomości rzeczywiście naruszające zasady | 1 000 |
| Poprawnie wykryte naruszenia | 990 |
| Przeoczone naruszenia | 10 |
| Fałszywe alarmy | 9 990 |
| Wszystkie alarmy | 10 980 |
Oznacza to, że w tym modelowym przykładzie około 91% wygenerowanych alarmów dotyczy wiadomości, które nie zawierają rzeczywistego naruszenia.
Nie dlatego, że klasyfikator jest wyjątkowo kiepski. Dlatego, że działa przy niskiej częstości występowania poszukiwanego zjawiska. To klasyczny base-rate problem. Sam wynik klasyfikacji nie jest więc równoznaczny z dowodem popełnienia przestępstwa.
Należy też zaznaczyć, że matematyka nie dowodzi niemożliwości uzyskania 100% skuteczności w każdym zamkniętym, odpowiednio zdefiniowanym problemie. Pokazuje natomiast, że nie można zagwarantować bezbłędnego wykrywania wszystkich przyszłych nadużyć w otwartym środowisku internetowym, zwłaszcza gdy system musi interpretować zmienny kontekst, intencję i zachowania przeciwnika.
Nie istnieje uniwersalny algorytm gwarantujący jednocześnie wykrycie każdego możliwego nadużycia i całkowity brak błędnych oskarżeń w dowolnej komunikacji.
I tutaj zaczyna się zasadniczy problem praktyczny. Każde fałszywe zgłoszenie wymaga potencjalnie dodatkowej analizy. Każdy błąd może dotyczyć rzeczywistego człowieka, jego korespondencji i prywatnych informacji. Sama możliwość przetworzenia miliona wiadomości na sekundę nie sprawia jeszcze, że system rozumie milion ludzkich rozmów.
Szyfrowanie end-to-end. Nie można być trochę odpornym na podsłuch
Kolejny problem dotyczy architektury komunikatorów. W prawidłowo zaprojektowanym systemie End-to-End Encryption (E2EE) treść wiadomości jest szyfrowana po stronie nadawcy i odszyfrowywana dopiero na urządzeniu odbiorcy.
Dostawca usługi nie powinien dysponować kluczami pozwalającymi mu na swobodne odczytywanie komunikacji. Rozważmy jednak wymóg analizy zawartości wiadomości. Jeżeli serwer nie ma dostępu do tekstu jawnego, pojawia się pytanie: gdzie miałaby odbywać się kontrola?
Jedną z rozważanych technik jest Client-Side Scanning (CSS), czyli analiza zawartości na urządzeniu użytkownika, przed jej zaszyfrowaniem lub po odszyfrowaniu. W takim wariancie nie trzeba matematycznie łamać algorytmu szyfrującego. Zamiast tego uzyskuje się możliwość analizy danych w punkcie końcowym.
Różnica techniczna jest zasadnicza, ale z punktu widzenia poufności komunikacji powstaje nowe ryzyko: wiadomość może zostać zbadana przez mechanizm inny niż zamierzony odbiorca. To problem architektury zaufania. Ponadto każdy dodatkowy komponent analizujący zawartość tworzy nową powierzchnię ataku (attack surface).
Kto aktualizuje jego reguły? Kto weryfikuje ich integralność? Jak zabezpieczane są wyniki analizy? Co stanie się w przypadku kompromitacji systemu aktualizacji? Cyberbezpieczeństwo polega między innymi na ograniczaniu zbędnych uprawnień i minimalizowaniu powierzchni ataku. Dlatego eksperci tak szczegółowo analizują konsekwencje wprowadzania dodatkowych mechanizmów dostępu do prywatnej komunikacji.
Czy da się wyeliminować hejt, przestępczość i wszystkie zagrożenia?
Nie istnieje technologia gwarantująca całkowite wyeliminowanie wszelkich nadużyć w otwartej sieci. Hejt wymaga interpretacji języka, relacji między rozmówcami i kontekstu. Cyberprzestępcy zmieniają techniki, infrastrukturę i sposoby działania. Mechanizmy wykrywania reagują na zjawiska, które same podlegają ciągłym zmianom.
W praktyce cyberbezpieczeństwa funkcjonuje pojęcie adversarial adaptation: przeciwnik dostosowuje zachowanie do metod stosowanych przez system obronny. Dlatego bezpieczeństwo projektuje się warstwowo. Prewencja, wykrywanie, analiza incydentów, ściganie sprawców, edukacja, kontrola uprawnień i ochrona urządzeń końcowych wzajemnie się uzupełniają.
Żaden pojedynczy filtr nie zastępuje całego tego ekosystemu. Tym bardziej nie należy utożsamiać liczby wykrytych materiałów ze skutecznością ochrony potencjalnych ofiar. Milion alarmów brzmi spektakularnie na konferencji prasowej. Jego wartość operacyjna zależy jednak od tego, ile alarmów było prawdziwych, ile pozwoliło powstrzymać przestępstwo i ile zasobów pochłonęła obsługa fałszywych trafień.
Bez tych informacji statystyka wygląda imponująco, ale nie pozwala ocenić rzeczywistego efektu.
Prywatność nie jest usterką, którą trzeba naprawić
Na koniec warto przypomnieć rzecz podstawową - poufność korespondencji nie powstała wraz z komunikatorami internetowymi. Jest znacznie starszą zasadą chroniącą możliwość prywatnego komunikowania się między ludźmi.
Współczesna technologia pozwala realizować ją przy pomocy kryptografii, protokołów bezpiecznej wymiany kluczy oraz odpowiednio zaprojektowanej infrastruktury. Dyskusja nad Chat Control dotyczy zatem nie tylko metod zwalczania konkretnych przestępstw. Dotyczy również tego, jakie mechanizmy dostępu do komunikacji powinny istnieć, kto może nimi zarządzać oraz jakie zabezpieczenia muszą ograniczać ich wykorzystanie.
To pytania, których nie rozwiąże sama zmiana nazwy projektu ani zapewnienie, że wszyscy uczestnicy procesu legislacyjnego mają dobre intencje. Dobre intencje nie stanowią mechanizmu kontroli dostępu. Nie są protokołem kryptograficznym. I zdecydowanie nie zastępują niezależnego audytu bezpieczeństwa.
Ostateczna architektura takich systemów powinna być oceniana nie tylko przez pryzmat deklarowanego celu, lecz również rzeczywistych kompetencji, które tworzy.
Bo w cyberbezpieczeństwie istotne jest nie tylko to, do czego dany mechanizm ma służyć dzisiaj. Równie istotne jest to, do czego będzie technicznie zdolny jutro.
Więcej informacji o inicjatywach:
Zawodowo związany z zarządzaniem infrastrukturą IT, cyberbezpieczeństwem i technologiami sieciowymi. Pasjonat prywatności cyfrowej, kryptografii, etycznego hackingu oraz wolności słowa w sieci. Zwolennik technicznej precyzji, niezależnego myślenia i zdrowego sceptycyzmu wobec wszelkich autorytetów. W HACKIN9 łączy praktyczne doświadczenie z zamiłowaniem do analizy technologii i jej wpływu na współczesny świat. Bez korporacyjnej nowomowy, niepotrzebnej sensacji i wiary w cudowne rozwiązania.
Komentarze (0)